목차
영상 소개
2026년 11월 12일 라이브에서 구독료 없이 내 컴퓨터에서 도는 로컬 AI로 목소리, 영상, 그림, 실시간 자막, 노래, 글을 하나씩 직접 만들어 봤습니다. 맥북 M5 Max 128GB와 200만원짜리 윈도우 PC에서 Qwen, MiniMax H3, Z-Image-Turbo, YuE2 같은 모델을 돌린 결과와 걸린 시간, 필요한 사양과 라이선스를 영상에 나온 숫자만으로 정리했습니다.
로컬 AI란, 챗GPT·클로드 같은 클라우드 AI와 무엇이 다를까
로컬 AI는 AI 모델 파일을 내 컴퓨터에 받아 두고, 내 컴퓨터의 칩과 메모리로 직접 돌리는 방식입니다. 한 번 받아 두면 모델은 인터넷이 끊겨도 돌아갑니다.
| 구분 | 클라우드 AI (챗GPT, 클로드 등) | 로컬 AI |
|---|---|---|
| 어디서 도나 | 회사의 데이터센터 | 내 컴퓨터 |
| 비용 | 월 구독료 (월 20달러, 100달러, 200달러 등) | 모델은 무료, 기기값과 전기요금 |
| 내 데이터 | 회사 서버로 보내짐 | 밖으로 나가지 않음 |
| 성능 | 최고 수준 | 내 컴퓨터 사양만큼 |
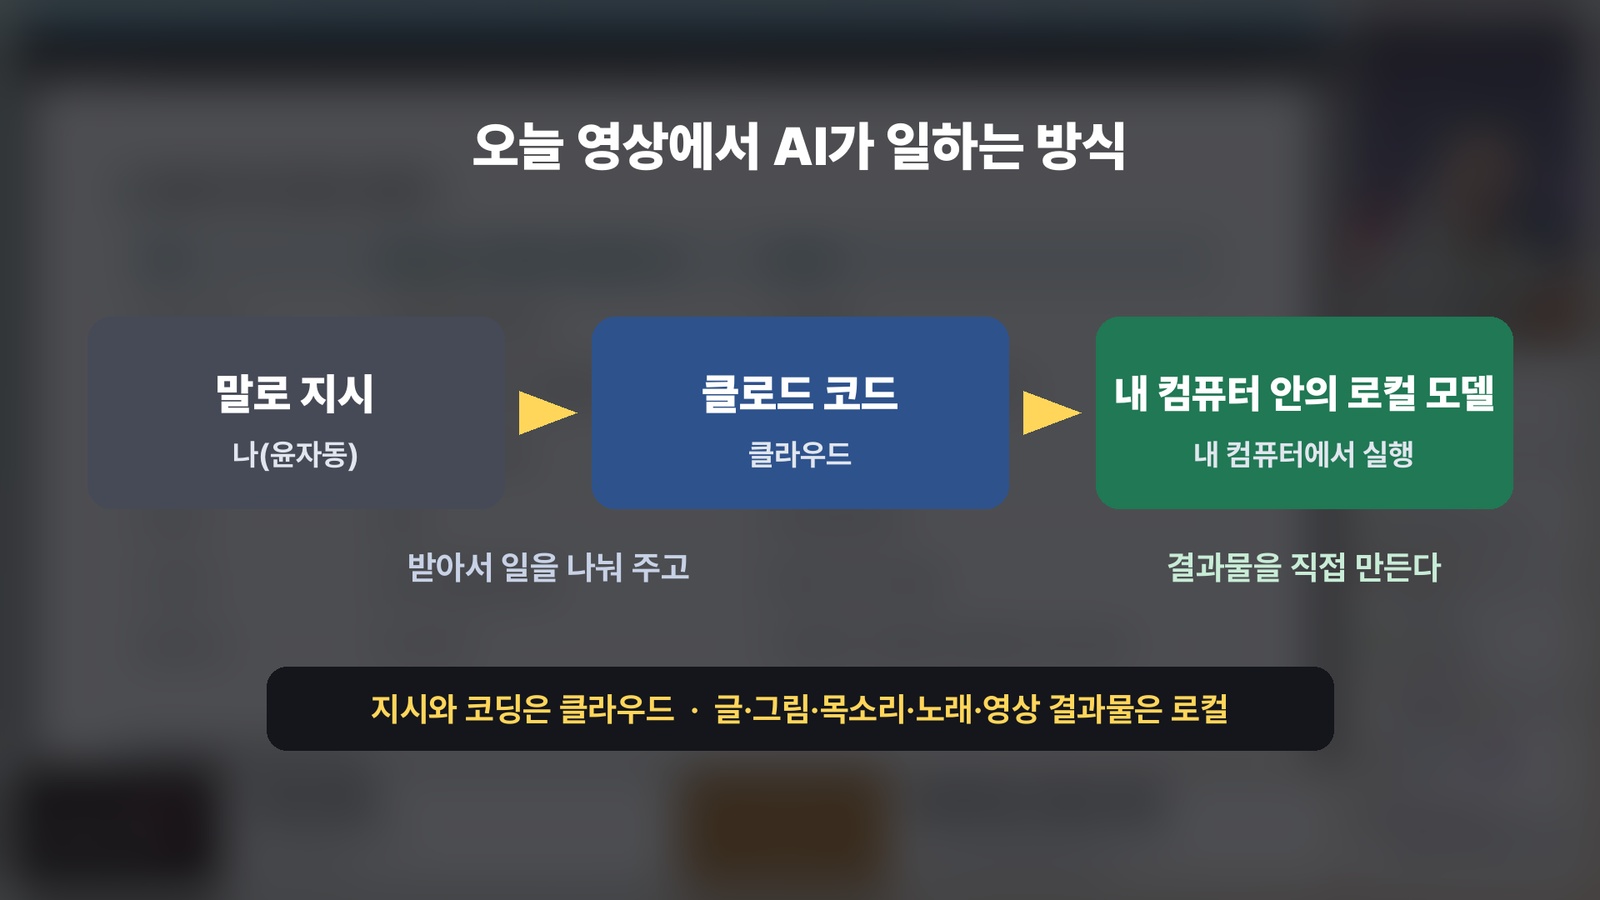
이번 라이브는 일을 두 곳에 나눴습니다. 말로 지시하면 클라우드에서 도는 클로드 코드가 받아서 일을 나누고 코드를 짜고, 글·그림·목소리·노래·영상 같은 결과물은 내 컴퓨터 안의 로컬 모델이 만들었습니다. 영상만은 맥북이 아니라 회사에 있는 윈도우 데스크톱이 만들었는데, 맥에서 윈도우에 일을 시키고 다 만든 영상을 다시 맥으로 가져오는 방식이었습니다.
맥북 M5 Max 128GB 가격과 로컬 AI 성능의 한계
로컬 AI는 컴퓨터 사양이 곧 성능입니다. 그래서 애플 공식 홈페이지에서 맥북 프로를 M5 Max 칩, 128GB 메모리로 가장 비싸게 맞춰 봤더니 애플케어를 넣어 14,474,000원이 나왔습니다.
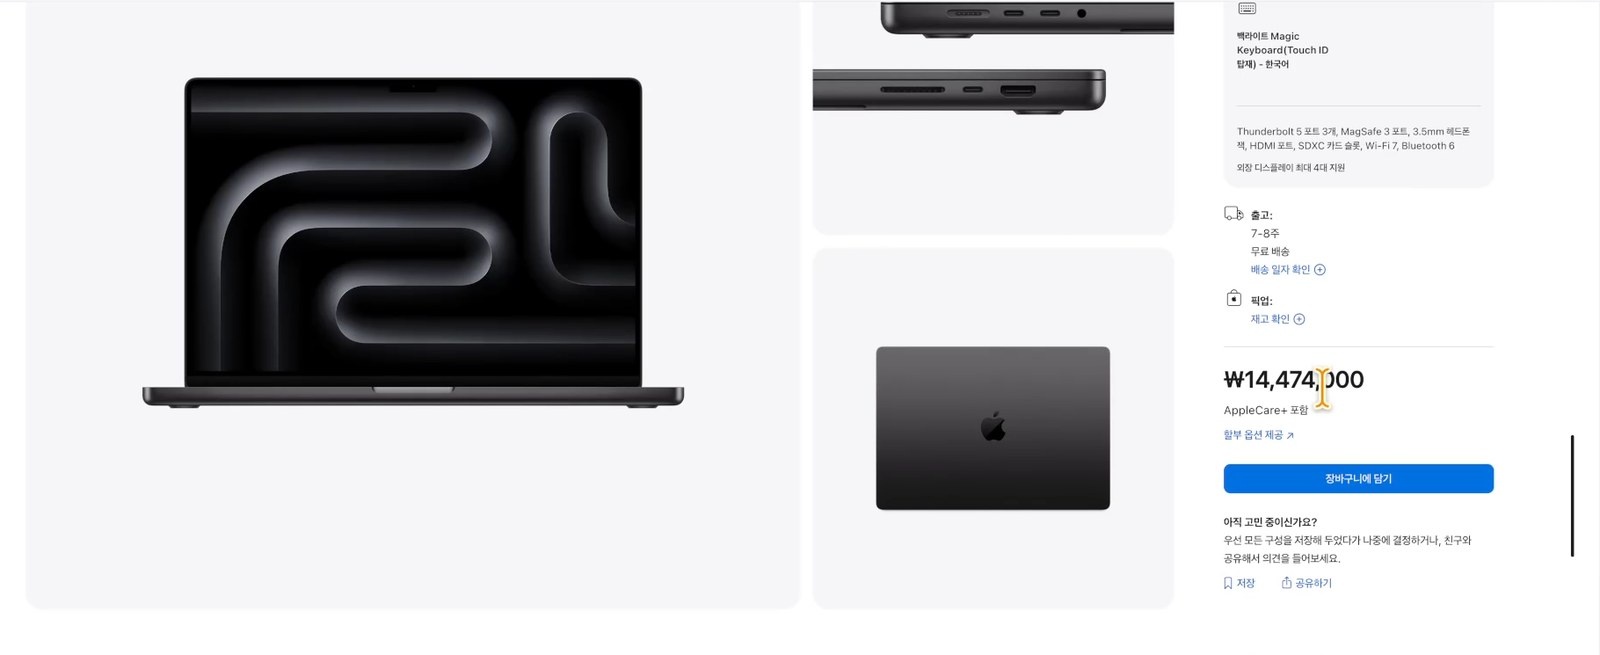
그런데 이렇게 비싼 컴퓨터로 돌려도 챗GPT나 클로드의 최고 모델과 비교하면 로컬 AI는 "좀 하찮은 수준"이라는 게 솔직한 결론이었습니다. 실제로 저도 평소 일은 돈 내고 클라우드 AI를 씁니다. 로컬 AI의 장점은 성능이 아니라 무료라는 점, 그리고 데이터가 밖으로 나가지 않는다는 점입니다.
Qwen3-TTS로 만든 내 목소리 AI 분신 '짭자동'
첫 시연은 목소리입니다. 클로드 코드에게 Qwen3-TTS 옴니 모델로 "채팅창 질문을 짧게 요약하고 답을 말로 해 줘, 내 컴퓨터의 개인정보는 말하지 마"라고 지시해 라이브를 돕는 AI 조수 '짭자동'을 만들었습니다.
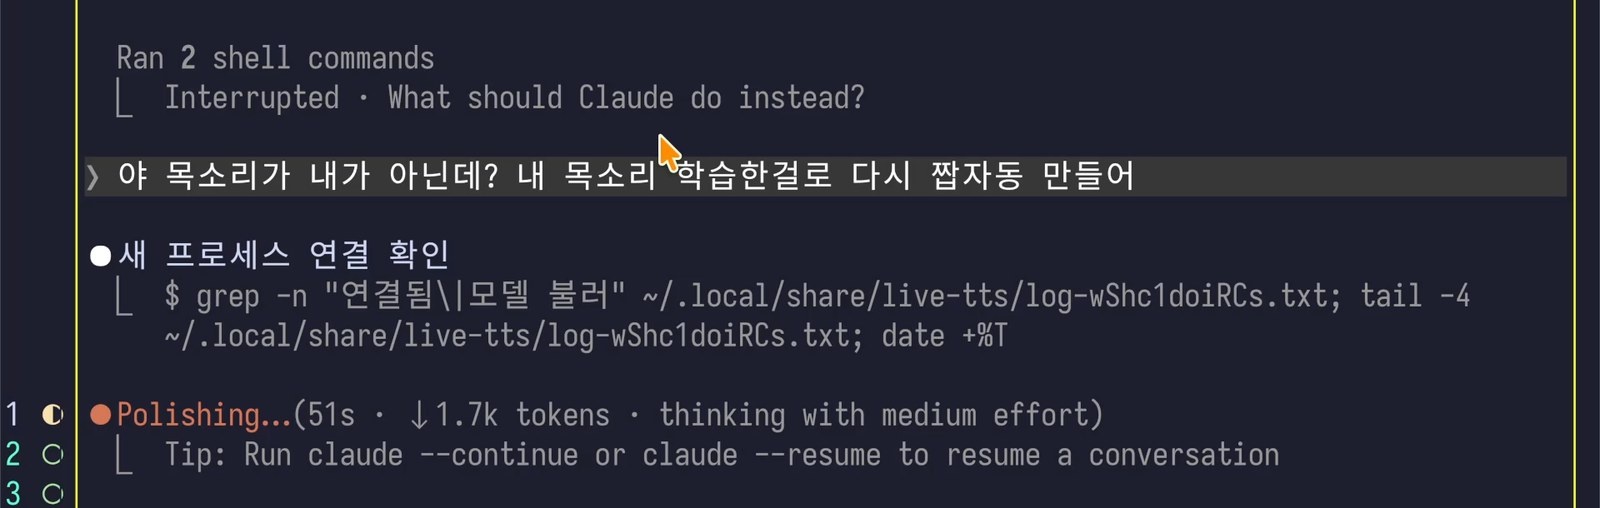
처음 나온 목소리는 기본 목소리였습니다. "목소리가 내가 아니잖아"라고 다시 지시하자 제 목소리를 학습한 복제 목소리로 바꿔 다시 시작했고, 그다음부터 짭자동이 제 목소리로 시청자 질문에 답했습니다. 이 목소리도 전부 로컬 AI라 무료입니다.
나중에는 질문에만 답하지 말고 혼자 방송한다고 생각하라고 시켰더니 스스로 말을 이어 갔습니다. 1500만원짜리 맥북을 "가성비 좋은 선택"이라고 답하는 등 엉뚱한 답도 섞여 있어서, 결과는 사람이 한 번 보고 고치는 편이 좋습니다.
MiniMax H3 로컬 AI 영상, 맥북 M5 Max vs RTX 5060 윈도우 PC
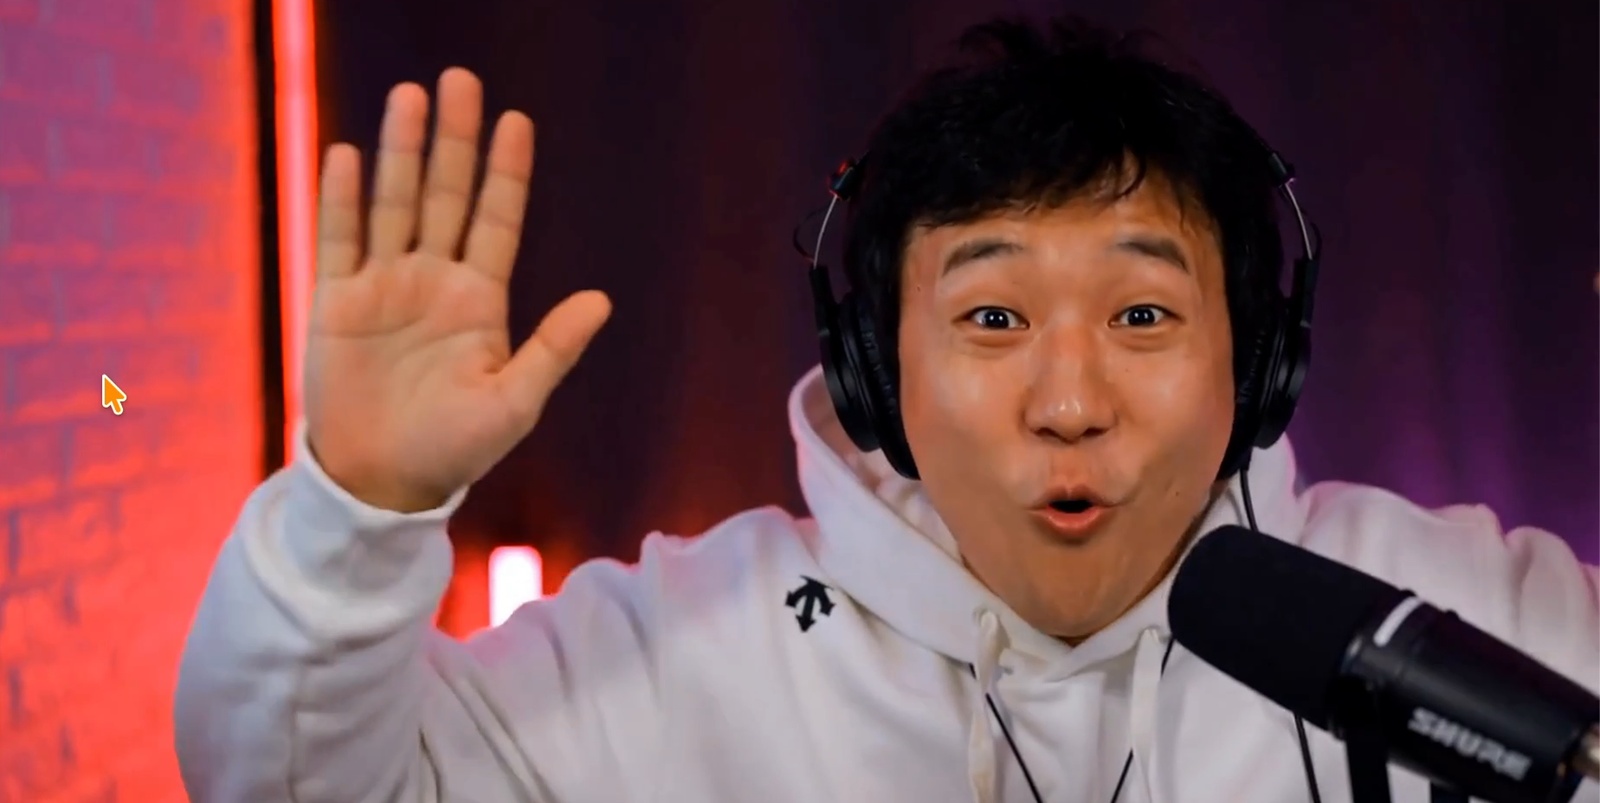
다음은 영상입니다. 라이브 중에 웃는 제 사진 한 장을 주고 MiniMax H3 모델로 "이 사진을 바탕으로 신나게 방송하는 모습"을 5초 영상으로 만들었습니다.
맥북 M5 Max 128GB로는 5초짜리 영상 하나에 약 11분이 걸렸습니다. 같은 일을 200만원짜리 윈도우 데스크톱에 시켰더니 시간이 오히려 절반으로 줄었습니다.
| 기기 (같은 지시문, 같은 시드, 5초, 1344×768) | 걸린 시간 |
|---|---|
| 윈도우 PC, RTX 5060 8GB | 345초 (5분 45초) |
| 맥북 M5 Max 128GB | 659초 (10분 59초), 메모리 약 43GB 사용 |
두 기기에서 나온 장면은 서로 달랐지만 품질은 비슷했습니다. 그래서 영상을 로컬로 만들고 싶다면 맥북보다 윈도우 PC가 낫다는 게 이번 실측의 결론입니다.
완성된 영상 속 제가 "여러분, 오늘 진짜 대박 소식 들고 왔습니다"라고 말합니다. 웃기긴 했지만 텐션은 실제 저와 완전히 달랐고, Seed-VC로 목소리를 제 음색으로 바꿔 보니 오히려 "목소리가 하나도 안 맞잖아요"라는 결과가 나왔습니다. 로컬 모델은 여러 번 테스트하고 고쳐 달라고 다시 시키는 과정이 필요합니다.
Z-Image-Turbo vs Qwen-Image 2.1, 로컬 AI 그림 생성과 한글 깨짐
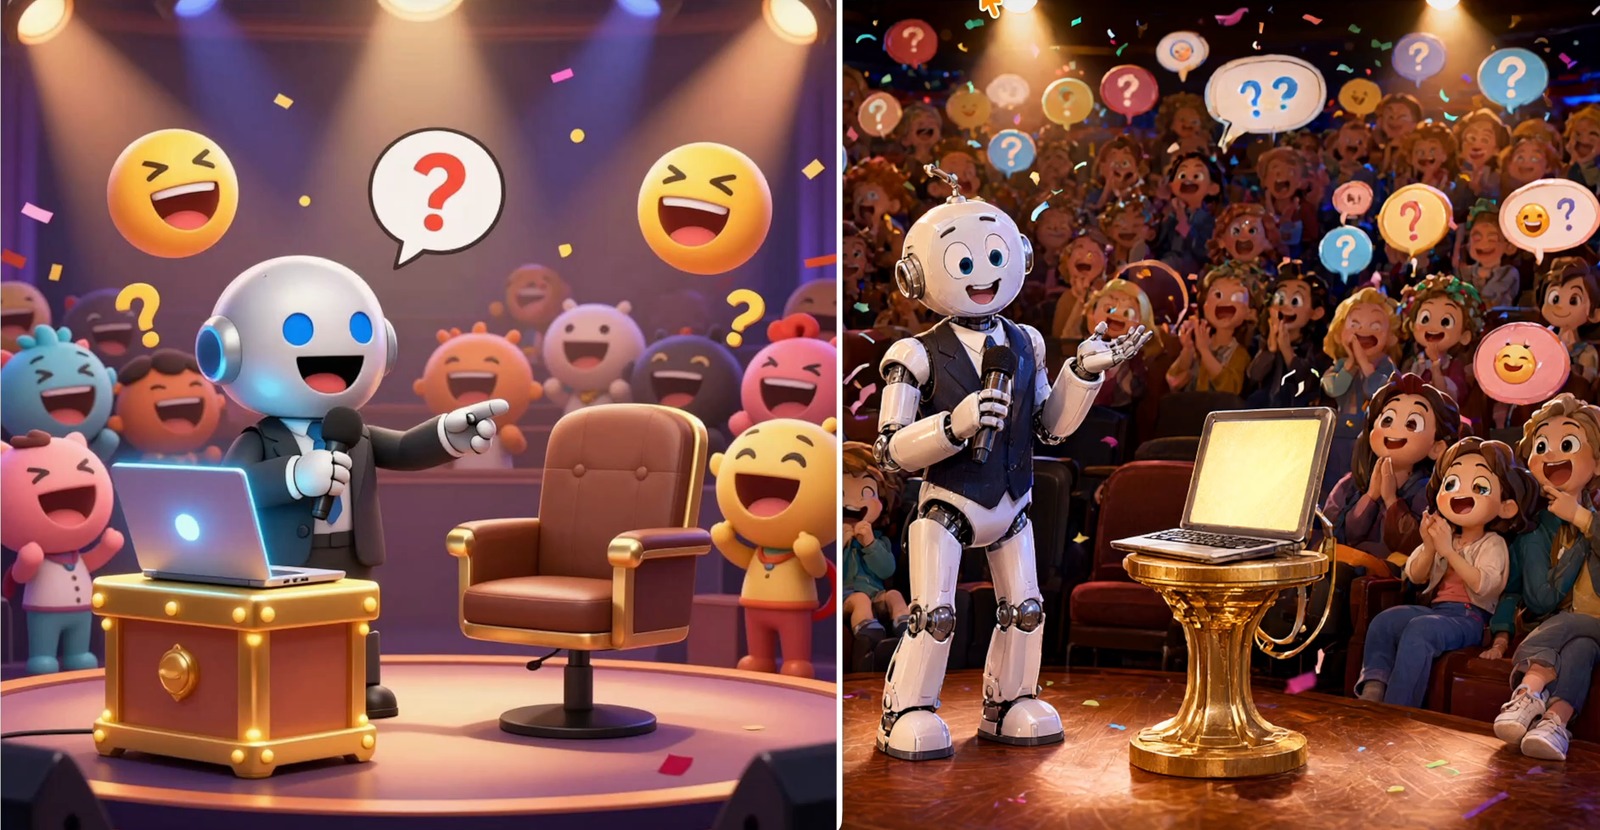
그림은 Z-Image-Turbo와 Qwen-Image 2.1을 비교했습니다. 한 장 그리는 데 Z-Image-Turbo는 약 21초, Qwen-Image는 100초 이상 걸렸습니다. 라이선스도 다릅니다. Z-Image-Turbo는 아파치 2.0이라 상업적으로 써도 되고, Qwen-Image는 연구용 라이선스라 상업 사용이 안 됩니다.
오늘 라이브 채팅을 전부 모아 어울리는 그림을 두 모델로 한 장씩 그리게 했더니, 짭자동 장면에 반응이 가장 많았다며 코미디 쇼 장면을 그렸습니다. 왼쪽이 Z-Image-Turbo, 오른쪽이 Qwen-Image입니다.
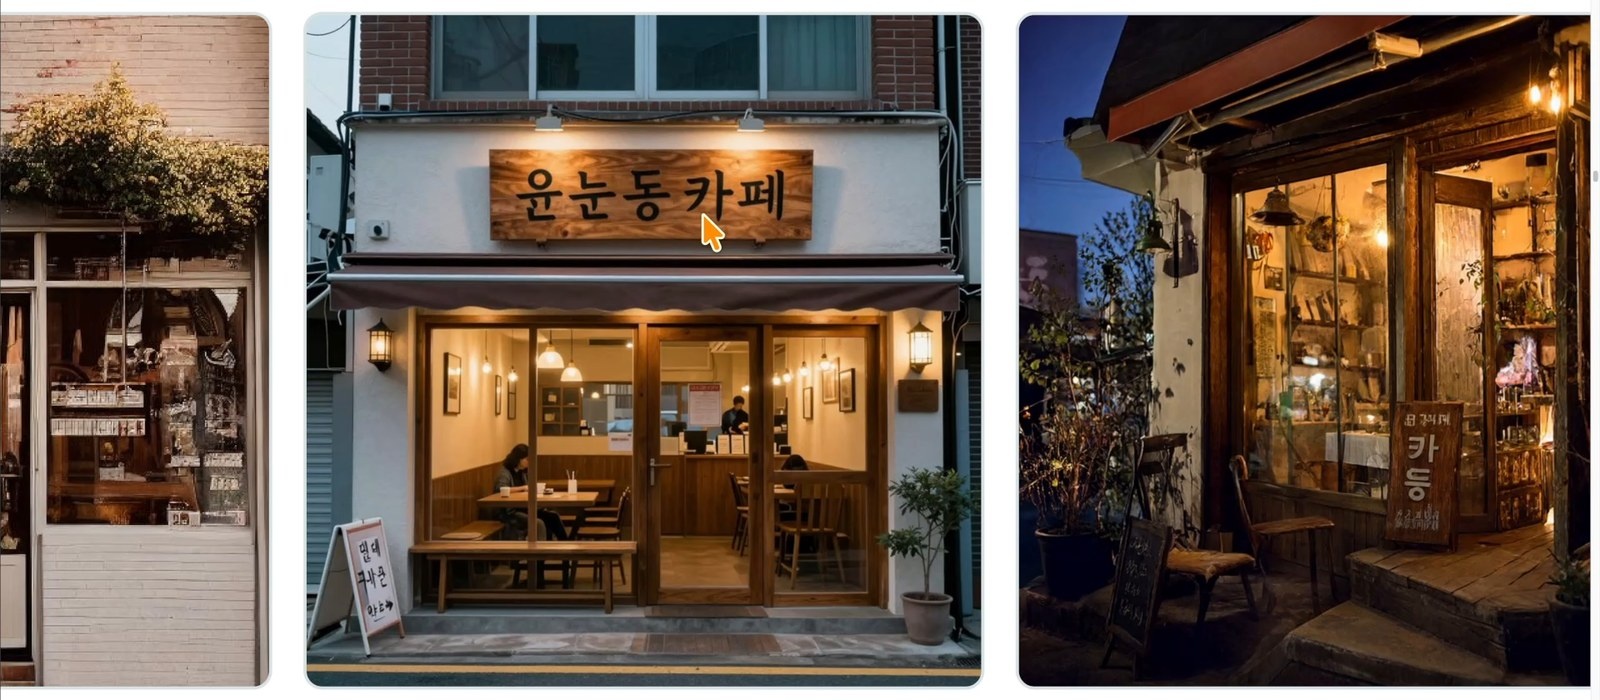
약점은 한글입니다. 그림에 '윤자동 카페' 간판을 넣으려다 '윤눈동 카페'가 나왔습니다. 예전 GPT나 제미나이 이미지 모델처럼 로컬 이미지 모델도 아직 한글을 잘 못 씁니다. 로컬 모델로 그림을 만들 때는 그림 속에 한글을 넣지 말라고 지시하는 게 좋습니다.
대신 비용이 들지 않습니다. 시간만 있으면 이미지 1만 장, 10만 장도 밤새 만들 수 있다는 게 로컬 AI 그림의 가장 큰 장점입니다.
Qwen3-ASR로 띄운 실시간 방송 자막
한 시청자가 "소리를 못 듣는 분도 볼 수 있게 라이브 화면 아래에 실시간 자막을 띄워 달라"는 아이디어를 줬고, 클로드 코드가 로컬 음성 인식 모델 Qwen3-ASR로 자막 프로그램을 만들었습니다. Qwen3-ASR은 Whisper와 같은 받아쓰기 모델로, 정확도를 앞세운 1.7B와 가볍고 빠른 0.6B가 있습니다(개발사는 0.6B가 실시간보다 약 2000배 빠르다고 설명합니다).
라이브에서는 0.6B로 말하는 중에도 0.9초마다 다시 받아써서 자막이 덜 밀리게 했습니다. 1.7B로 바꾸면 더 정확해질 수 있지만 자막이 늦게 뜰 수 있다고 해서 0.6B를 골랐습니다.
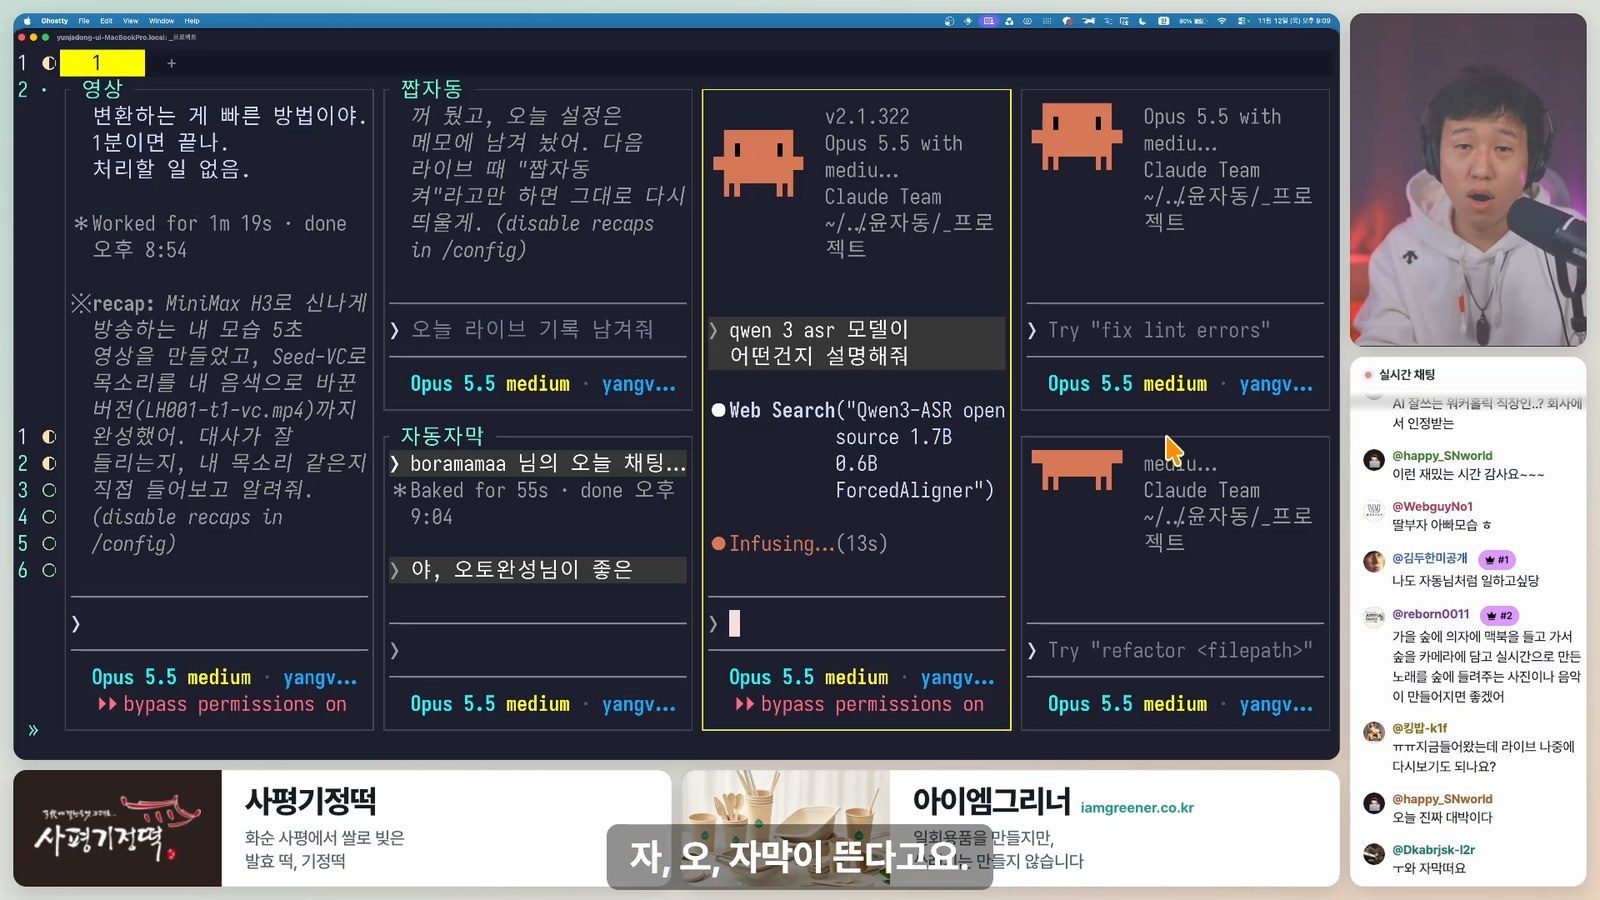
또박또박 말하면 꽤 맞았지만 웅얼거리듯 말하면 엉망으로 나왔습니다. 맥에서 나는 소리까지 자막에 넣으려다 자막이 통째로 꺼지기도 했는데, OBS 브라우저 화면을 새로 고치자 다시 나왔습니다. 정확도는 상용 서비스만 못해도, 내 컴퓨터에서 무료로 실시간 자막이 된다는 점은 확인했습니다.
YuE2 로컬 AI 노래 만들기, 57곡을 만든 시간과 사양
노래는 YuE2 모델로 만들었습니다. 라이브 채팅에 나온 말을 모아 출석송, '채팅창 친구들', '휴게소 사바리' 같은 노래를 만들었고, 지금까지 이렇게 만든 노래가 57곡입니다. 전부 로컬이라 무료이고, 마음만 먹으면 하루에 100곡도 만들 수 있습니다.
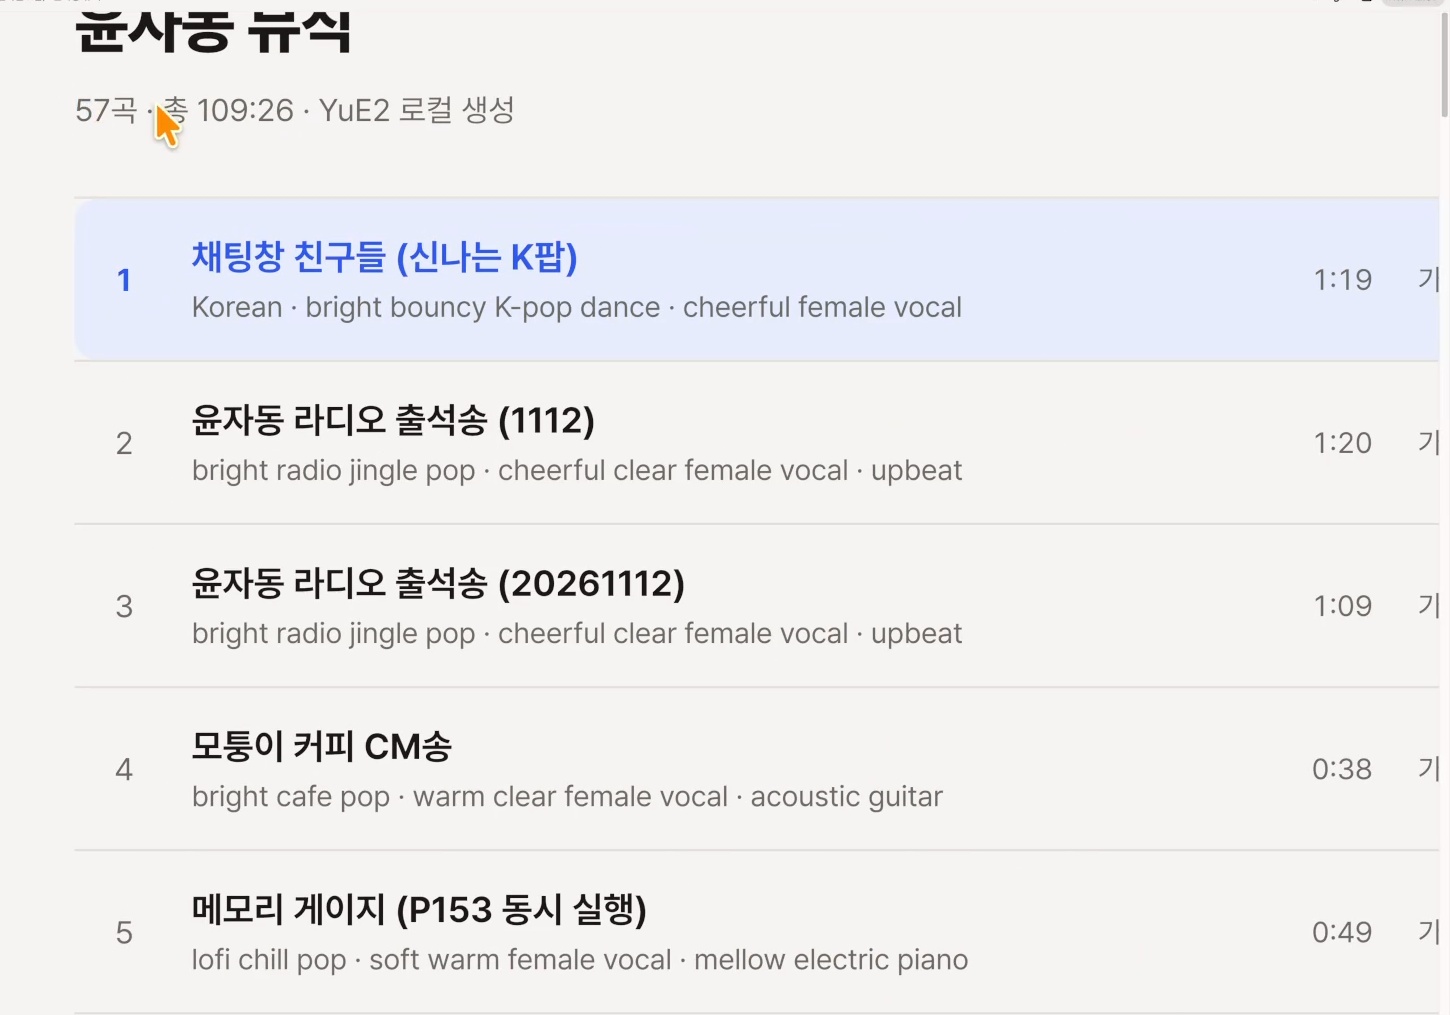
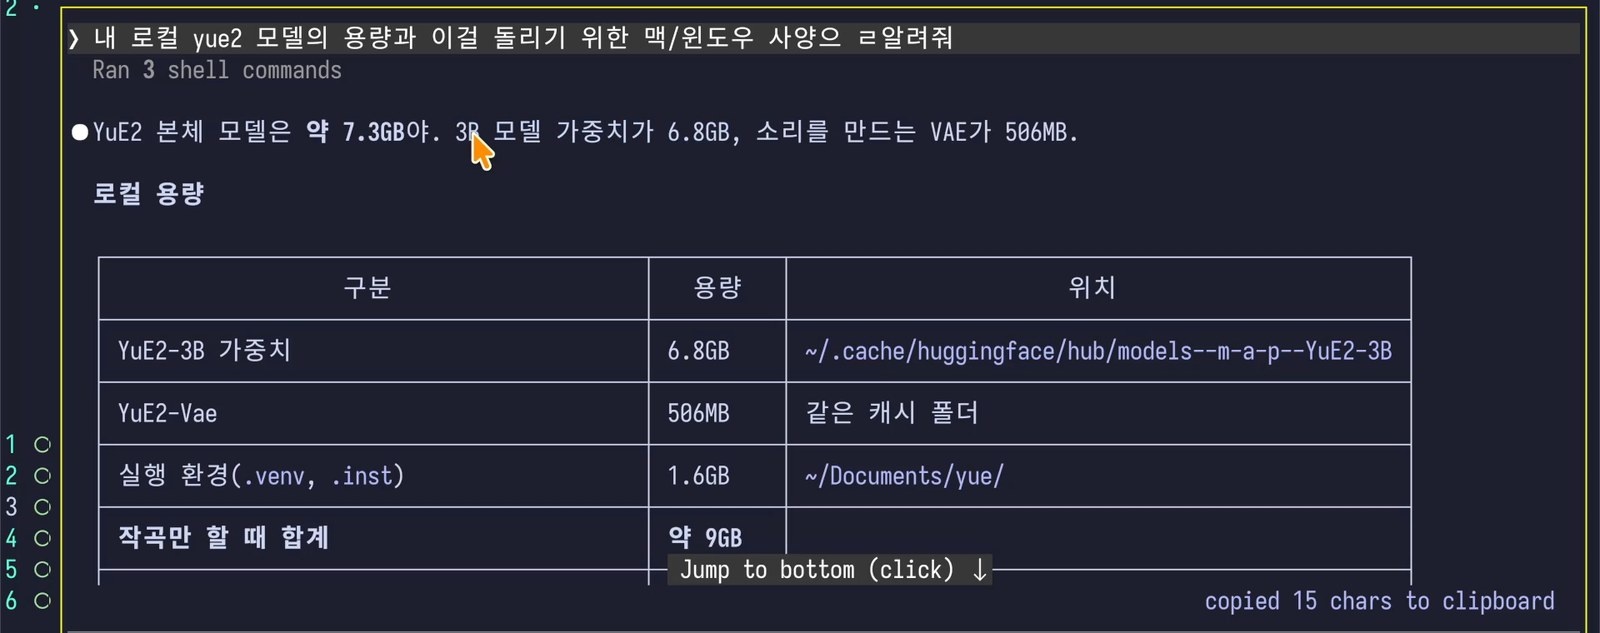
만드는 시간은 생각보다 짧습니다. 1분짜리 노래는 53초, 2분짜리 노래는 3분 정도 걸렸습니다. 길어질수록 시간이 빠르게 늘어나니 처음에는 1분 안쪽으로 만드는 게 좋습니다. YuE2 본체 모델은 약 7GB(3B 모델)로 무겁지 않아서, 램 16GB 정도면 돌릴 수 있을 것으로 봤습니다.
라이선스는 꼭 확인해야 합니다. YuE2는 기본이 비상업 라이선스이고, 개인 창작자에게는 수익화까지 허락하는 조항이 있습니다. 회사 이름으로 하는 광고나 납품에는 별도 상업 라이선스가 필요합니다.
Qwen3.8 Flash Next로 해 본 채팅 관상 분석, 128GB 램이 필요한 이유
글과 코딩용 로컬 모델 중에서는 Qwen3.8 Flash Next가 가장 성능이 높습니다. 대신 돌리려면 모델 용량만 87GB, 램은 최소 128GB가 필요합니다. 오늘 라이브 채팅을 전부 모아 닉네임별 성향과 나이를 맞혀 보라고 하자, 클로드 코드가 이 일을 로컬 Qwen에게 맡겼고 128GB 맥북의 메모리 사용률이 93%까지 올라갔습니다.
결과는 웹 페이지로 나왔습니다. 시청자 24명의 채팅 75개를 205.2초 동안 분석했고, 맥북 안에서 초당 21.2토큰 속도로 글을 썼습니다(브라우저 채팅에서는 초당 약 24토큰). 분석 글은 로컬 Qwen이 썼고, 페이지 틀은 클로드 코드가 짰습니다. 단서가 부족한 한 명은 "추정 불가"로 나왔습니다.
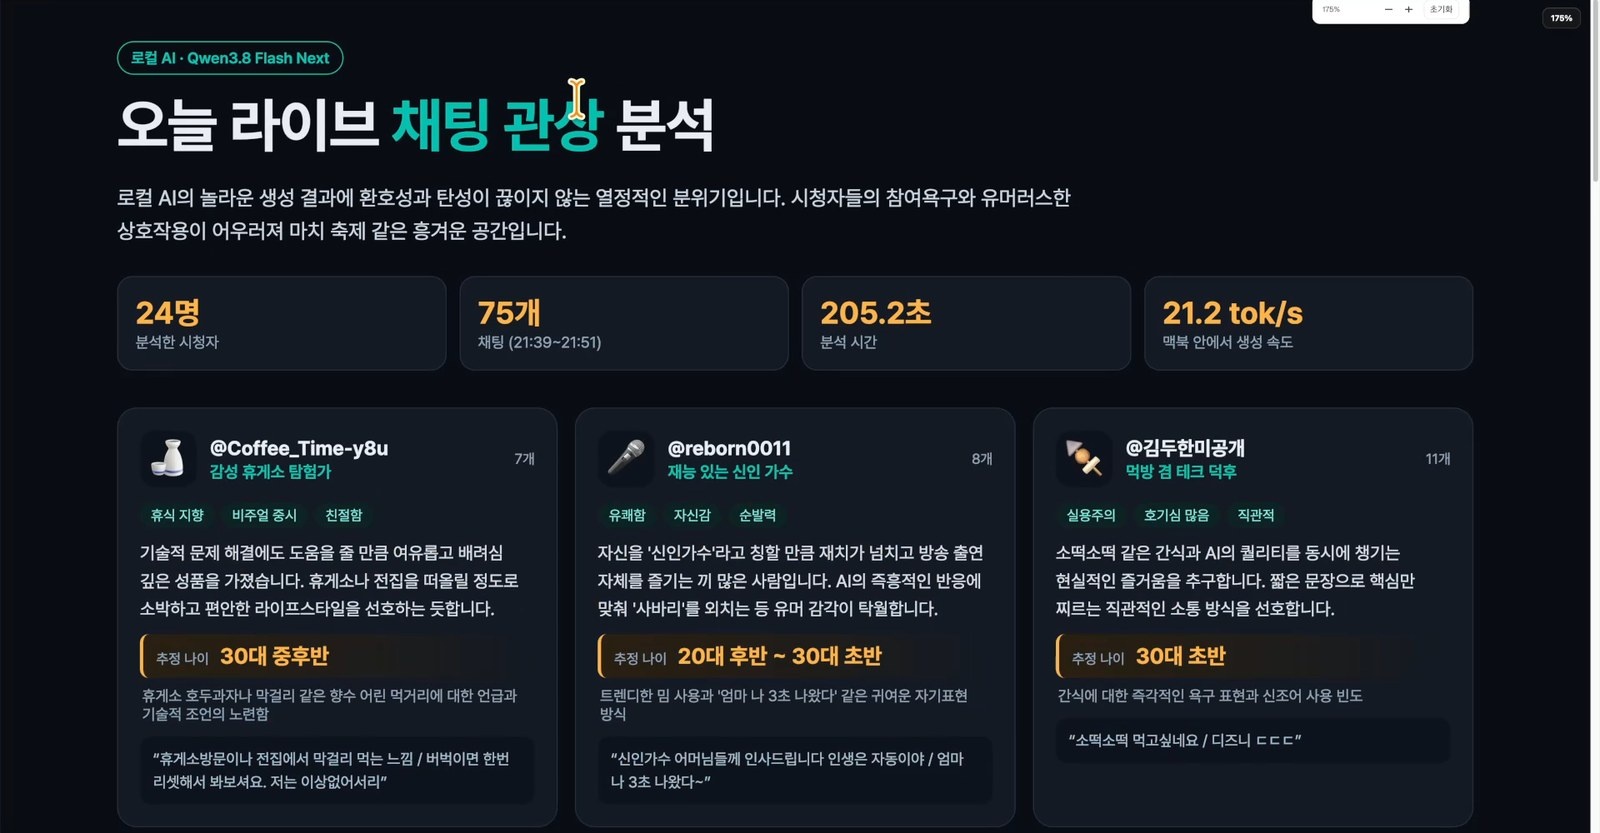
채팅 말투만 보고 재미로 추측한 결과지만, 데이터를 인터넷으로 보내지 않고 맥북 안에서만 분석했다는 점이 핵심입니다. 개인정보 유출이나 토큰 비용이 걱정되는 경우 로컬 모델을 고민해 볼 만합니다. 다만 이 모델을 쓰려면 128GB 램이 필요해서 컴퓨터에만 기본 1000만 원 정도는 들어갑니다.
로컬 AI 필요 사양과 라이선스 한눈에 보기
| 모델 | 이번에 만든 것 | 영상에서 확인한 사양·속도 | 라이선스 |
|---|---|---|---|
| Qwen3.8 Flash Next | 채팅 관상 분석 글 | 모델 87GB, 램 최소 128GB, 초당 약 21~24토큰 | 월 사용자 1억 명 또는 월 매출 2천만 달러가 넘는 서비스는 조건이 붙음 |
| Qwen3-TTS 옴니 | 내 목소리 AI 조수 짭자동 | 영상에서 다루지 않음 | 아파치 2.0, 남의 목소리 복제는 동의가 필요 |
| MiniMax H3 | 5초 영상 | 윈도우 RTX 5060 8GB 345초, 맥북 M5 Max 128GB 659초 | 한국·EU·영국·미국은 원래 사용 제외 지역, 사용 신청 후 승인, 공개할 때 AI 생성 표기 |
| Z-Image-Turbo | 채팅으로 그린 그림 | 한 장 약 21초 | 아파치 2.0, 상업 사용 가능 |
| Qwen-Image 2.1 | 그림 비교 | 한 장 100초 이상 | 연구용 라이선스, 상업 사용 불가 |
| Qwen3-ASR 0.6B | 실시간 방송 자막 | 0.9초마다 다시 받아쓰기 | 영상에서 다루지 않음 |
| YuE2 (3B) | 채팅으로 만든 노래 | 본체 약 7GB, 램 16GB 정도, 1분 곡 53초 | 기본 비상업, 개인 창작자는 수익화 가능, 회사 광고·납품은 별도 상업 라이선스 |
라이선스는 잘못 쓰면 문제가 되는 부분이라 가장 중요합니다. 아파치 2.0은 상업적으로 써도 되지만, 모델마다 조건이 다르고 바뀔 수도 있으니 쓰기 전에 원문을 다시 확인하세요. MiniMax처럼 사용 신청이 필요한 모델은 신청 과정도 AI에게 맡길 수 있습니다. 참고로 이번 라이브에서 시청자 캐릭터 그림만은 로컬이 아니라 GPT 이미지 모델로 만들었습니다.
세 줄 요약
- 로컬 AI로 목소리, 영상, 그림, 자막, 노래, 글까지 내 컴퓨터에서 무료로 만들 수 있다. 지시와 코딩은 클로드 코드가, 결과물은 로컬 모델이 만들었다.
- 품질은 상용 AI가 위다. 대신 횟수 제한과 비용이 없고 데이터가 밖으로 나가지 않는다.
- 영상은 1500만원 맥북보다 200만원 윈도우 PC가 약 두 배 빨랐고, 상업적으로 쓰기 전에는 모델별 라이선스를 꼭 확인해야 한다.
라이브 전체 다시보기: https://youtu.be/wShc1doiRCs