GPT-5 출시: 챗봇에서 에이전트로 진화, 환각률 대폭 감소
<iframe src="https://www.youtube.com/embed/0Uu VJeVVfo" title="YouTube 영상" allowfullscreen </iframe 2025년 8월 7일, 오픈AI(OpenAI)가 차세대 인공지능 모델 GPT 5를 공개했다
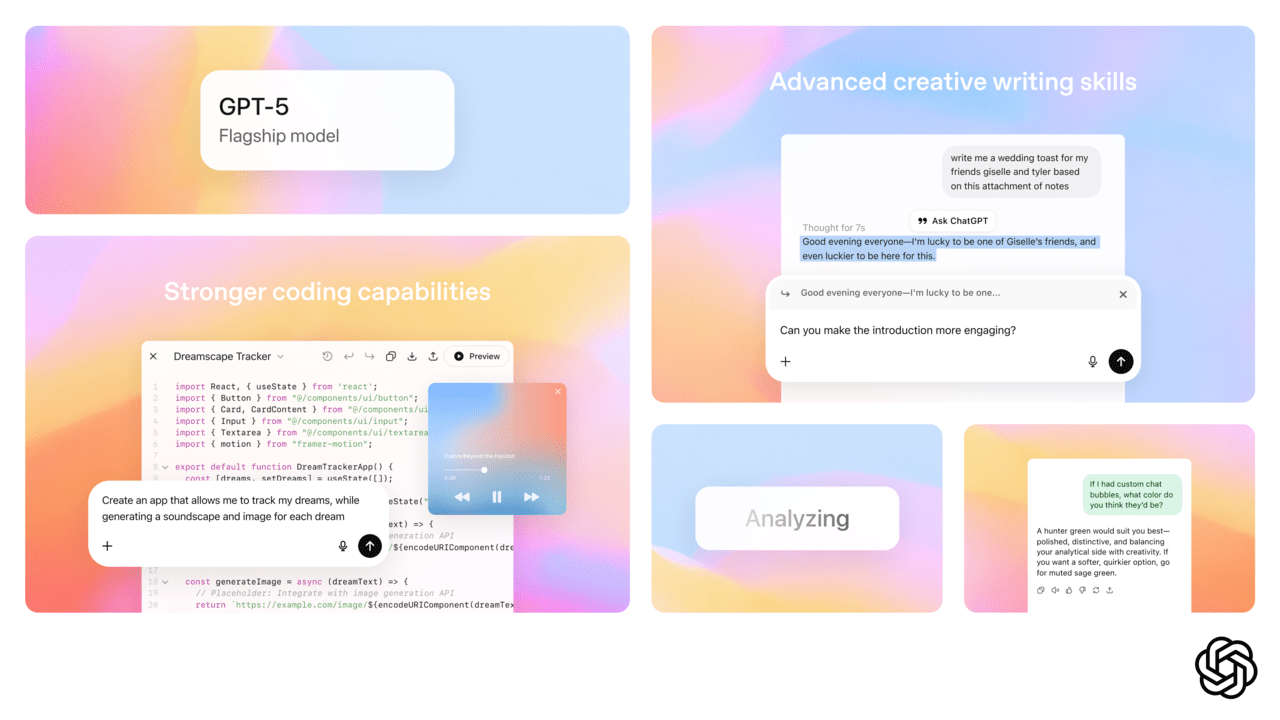
2025년 8월 7일, 오픈AI(OpenAI)가 차세대 인공지능 모델 GPT-5를 공개했다. 이번 모델은 GPT-4 대비 성능 점수의 큰 격차는 없지만, 코딩·에이전트 기능의 향상과 환각(Hallucination) 현상의 대폭 감소가 특징이다. 단순한 챗봇을 넘어 AI 에이전트로의 전환을 공식화했다.
주요 특징
- 코딩 및 에이전트 성능 강화
GPT-5는 ‘SWE-벤치 베리파이드’ 테스트에서 74.9%를 기록했다. 이는 구글 Gemini 2.5 Pro(59.6%)를 크게 앞섰고, 클로드 Opus 4.1(74.5%)을 근소하게 앞질렀다.
또한 사용자 대신 소프트웨어를 생성하거나 연구 보고서를 작성하는 등 실행 중심의 작업 수행 능력이 강화됐다.
실시간 라우터 기능이 새롭게 추가되어, 사용자 입력에 따라 추론·비추론·도구 사용 모드를 자동으로 선택한다.
- 환각률 대폭 감소
의료 분야 테스트인 HealthBench Hard Hallucinations에서 환각 비율은 1.6%에 불과했다.
이는 GPT-4o(12.9%)와 o3(15.8%) 대비 큰 폭으로 감소한 수치다.
전체 프롬프트 평균 환각률 역시 4.8%로, o3(22%)와 GPT-4o(20.6%)보다 현저히 낮았다.
- 창의성과 사용자 맞춤성 강화
글쓰기, 디자인 등 주관적 작업에서의 반응 품질이 향상됐다.
모델 설정에서 냉소주의자, 로봇, 청취자, 괴짜 등 네 가지 성격을 선택할 수 있으며, 사용자가 직접 프롬프트를 작성하지 않아도 원하는 응답 스타일을 얻을 수 있다.
- 안전성 개선
다른 모델 대비 기만적 행동 비율이 낮으며, 무해한 요청을 불필요하게 거부하는 횟수가 줄었다.
안전하지 않은 질문은 여전히 차단하지만, 무해한 요청은 보다 원활하게 처리한다.
- API 제공 및 가격
개발자를 위해 GPT-5, GPT-5-미니, GPT-5-나노 모델이 API에 추가됐다.
API 가격은 100만 입력 토큰당 1.25달러, 출력 토큰당 10달러로 GPT-4o와 유사한 수준이다.
주요 벤치마크 결과
테스트명GPT-5비교 모델
| SWE-벤치 베리파이드 | 74.9% | Gemini 2.5 Pro 59.6%, Claude Opus 4.1 74.5% |
| Tau-bench (항공사 웹 탐색) | 63.5% | o3: 64.8% |
| Tau-bench (소매 웹 탐색) | 81.1% | Claude Opus 4.1: 82.4% |
| GPQA 다이아몬드 | 89.4% | Claude Opus 4.1: 80.9%, Grok 4 Heavy: 88.9% |
| HealthBench Hard Hallucinations | 1.6% | GPT-4o: 12.9%, o3: 15.8% |
종합 평가
GPT-5는 벤치마크 점수에서 압도적인 성과를 보여주지는 못했지만, 실행형 에이전트로의 전환과 환각률 감소에서 중요한 발전을 이루었다.
특히 환각률의 대폭 하락은 의료, 연구 등 높은 정확성이 요구되는 분야에서 신뢰도를 높일 수 있는 요인으로 평가된다.